📅 2026年10月26日
🏷️ カテゴリー:AI・ITニュース・ローカルAI・音声生成
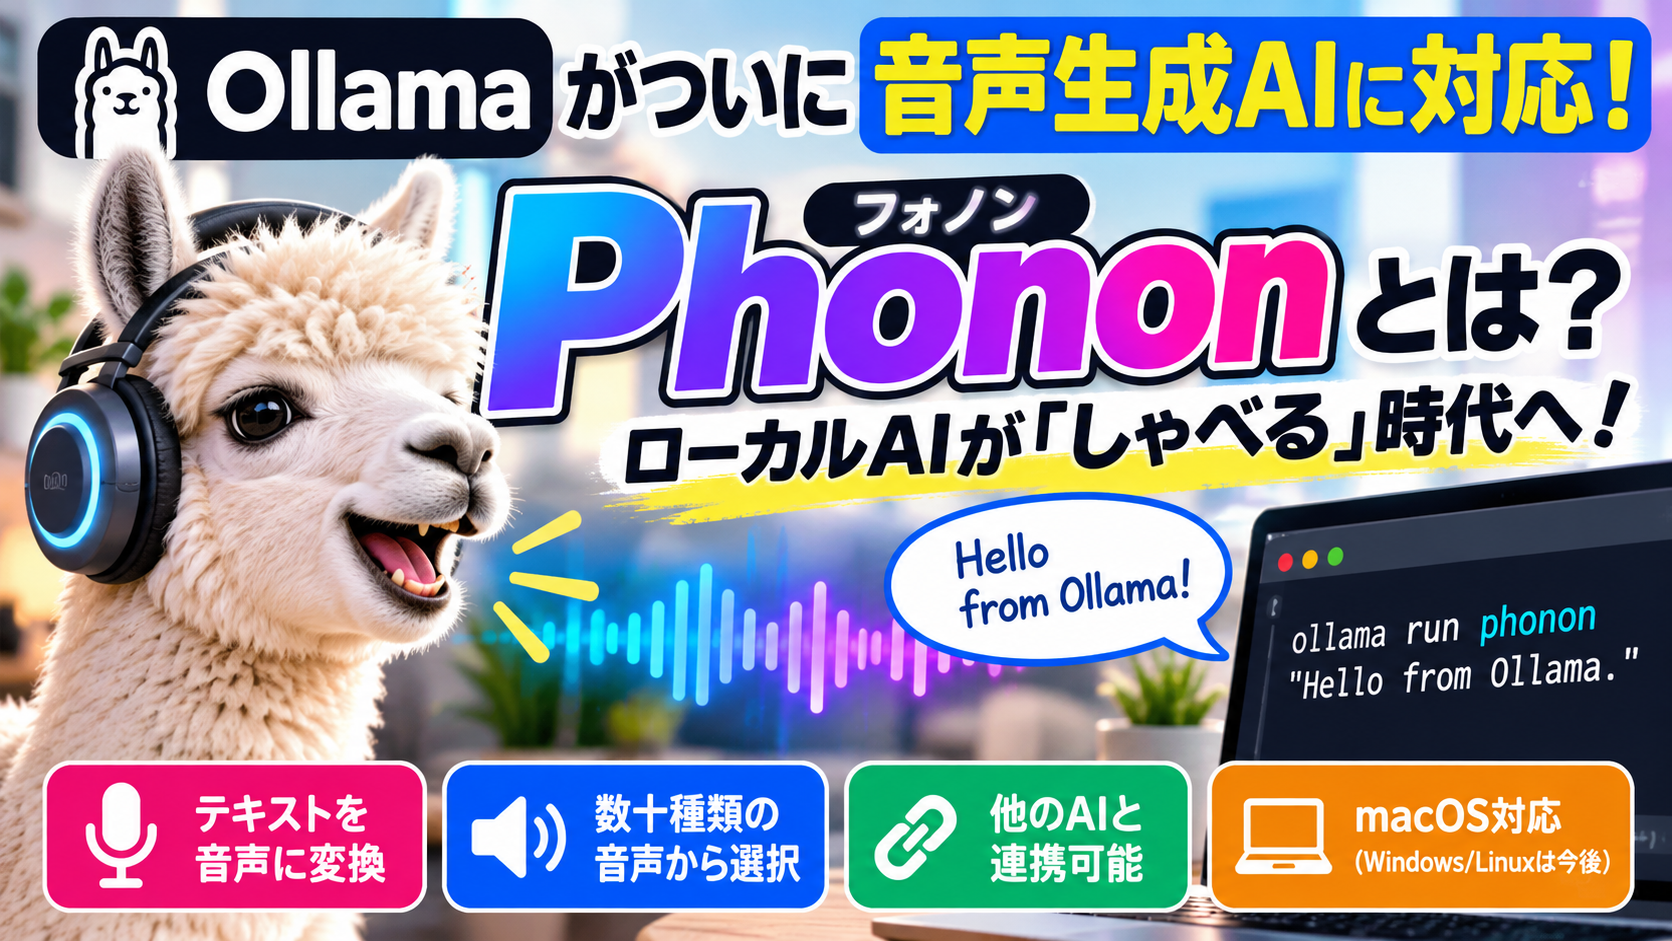
🚀 Ollamaに新機能「Speech models」が登場!
ローカル環境でAIを動かせることで人気の Ollama(オラマ) に、新たな機能が追加されました!
その名も 「Speech models(音声モデル)」 🎉
今回のアップデートによって、Ollamaで文章を音声に変換する「Text-to-Speech(TTS)」が利用できるようになりました。
つまり、これまで文章で回答していたAIが、今度は実際に声を出して話せるようになるということです。
しかも、対応するモデルを使えば、音声生成を自分のパソコン上で処理できます。
🤖 AIが文章を考える
⬇️
📝 AIが回答を作成する
⬇️
🎙️ 音声モデルが文章を読み上げる
⬇️
🔊 パソコンのスピーカーから声が聞こえる!
これにより、自分専用のAIアシスタントや、ゲームのキャラクターに声を付けるシステムなど、さまざまな可能性が広がります。
今回は、この新機能について初心者の方にも分かりやすく紹介していきます!
🤔 そもそもOllamaとは?
Ollamaは、ChatGPTのような生成AIのモデルを、自分のパソコンで実行できるソフトウェアです。
通常、ChatGPTなどのオンラインAIサービスでは、インターネット経由でサーバーにアクセスし、AIに質問します。
一方、Ollamaは対応するAIモデルをパソコンにダウンロードして、ローカル環境で動作させることができます。
💡 Ollamaの特徴
✅ インターネットに依存せずAIを実行できるモデルがある
✅ 外部のAI APIを使わずに処理できる
✅ 自分のPCでAIを動作させられる
✅ Pythonなどのプログラムから利用できる
✅ AIを組み込んだ独自アプリを開発できる
※モデルのダウンロードには通常インターネット接続が必要です。また、対応ハードウェアやライセンス条件はモデルごとに異なります。
例えば、社内情報や個人的なデータを外部サービスに送信したくない場合にも、ローカルAIは有力な選択肢になります。
🎤 新しく登場した音声モデル「Phonon」とは?
今回Ollamaに追加された代表的な音声モデルが、Gradiumが開発した「Phonon(フォノン)」 です。
Phononは、文章を人間の声のような音声へ変換するAIモデルです。
この技術をTTS(Text-to-Speech)と呼びます。
🎯 どんなことができる?
例えば、次の文章を入力します。
「Hello from Ollama.」
すると、AIがこの文章を音声として読み上げます。
単純な文章の読み上げだけでなく、音声生成が完了する前から再生を始められるストリーミング機能にも対応しています。
📊 Phononの特徴
| 項目 | 内容 |
|---|---|
| 開発元 | Gradium |
| 機能 | テキストから音声を生成 |
| デフォルトモデル | Phonon 31M English |
| モデルの規模 | 約3,100万パラメータ |
| 音声出力 | 24kHz・モノラル |
| 音声ファイル | WAV形式など |
| 音声の種類 | モデルによって選択可能 |
| 実行環境 | Apple Silicon搭載Mac向けパッケージ |
さらに、英語のほかフランス語、ドイツ語、スペイン語、ポルトガル語などの40Mモデルも公開されています。
⚠️ 注意:日本語は?
2026年10月26日時点で公開されているPhononの公式モデル一覧には、日本語専用モデルは掲載されていません。
日本語を自然に読み上げることを目的とする場合は、日本語対応の別のTTSモデルを検討する必要があります。
💻 Ollamaで音声を生成する方法
実際の操作は非常にシンプルです。
① Ollamaをインストールする
まず、公式サイトからOllamaをダウンロードします。
今回の公式メールでは、Ollama 0.40.11への更新が案内されています。
公式ドキュメントでは0.40.9以降の記載もありますが、新機能を試す場合は最新の対応版を利用するのがおすすめです。
② 音声モデルをダウンロードする
ターミナルを開き、次のコマンドを入力します。
ollama pull phononこれで音声生成モデルがダウンロードされます。
③ AIにしゃべらせる!
続いて、以下のコマンドを実行します。
ollama run phonon "Hello from Ollama."すると、パソコンのスピーカーから音声が再生されます。🔊
たったこれだけで音声生成を試せます。
④ 声の種類を変更する
対応する音声を指定することもできます。
ollama run phonon --voice Zoey "Hello!"利用可能な音声は、以下のコマンドで確認できます。
ollama show phononただし、選択できる音声の種類は使用するモデルによって異なります。
⑤ 音声ファイルとして保存する
読み上げるだけではなく、生成した音声をWAVファイルとして保存できます。
ollama run phonon "Hello from Ollama." > speech.wavこれを活用すれば、動画のナレーションやゲーム用音声なども作成できそうですね!
🤖 AI同士を連携させれば、会話するAIも作れる!
今回のアップデートで特に注目したいのが、ほかのAIモデルとの連携です。
例えば、文章生成AIが考えた回答を、音声生成AIに渡して読み上げさせることができます。
公式に紹介されている例はこちら。
ollama run gemma4 --hidethinking "Tell me a fun fact about owls in two sentences." | ollama run phononこの仕組みでは、
① Gemma 4が質問に回答する
② 回答文章をPhononに渡す
③ Phononが音声に変換する
④ スピーカーから回答が流れる
という処理になります。
🎉 つまり、AIが考えたことを、そのまま声に出して話せるわけです!
さらに音声認識(Speech-to-Text)を別途組み合わせれば、人間が話しかけて、AIが音声で返事をするシステムも構築できます。
🛠️ 具体的にどんなことに使える?
音声生成AIは、単に文章を読み上げるだけの技術ではありません。
ほかのプログラムと組み合わせることで、さまざまな分野に活用できます。
🖥️ ① サーバー監視システム
例えば、システム障害を検知した際に音声で知らせる仕組みです。
🚨 サーバーで障害発生!
⬇️
🔍 監視プログラムが異常を検知
⬇️
🤖 AIが障害内容を文章化
⬇️
🔊 「サーバーで異常を検知しました」
画面を確認していなくても、音声で状況を把握できるようになります。
PowerShellやPythonで作成した監視ツールとの連携も考えられます。
🎮 ② ゲームのキャラクターに声を付ける
ゲームのNPC(ノンプレイヤーキャラクター)にAIを組み込む活用方法もあります。
プレイヤーが質問すると、AIがその場で回答を考え、音声で返事をする仕組みです。
例えば、
👤 プレイヤー:「この町には何があるの?」
🤖 NPC:「この先には大きなお城があります」
従来のように決められたセリフだけではなく、その場の状況に応じた会話を生成するゲームも開発できるようになります。
※リアルタイム性や自然な会話の実現には、処理速度や追加のシステム設計が必要です。
🏠 ③ 自分専用のAIアシスタント
パソコンや小型デバイスに組み込むことで、家庭用AIアシスタントとして活用できます。
例えば、
🌤️ 今日の天気を読み上げる
📅 予定を音声で知らせる
📧 メールの内容を要約して話す
⏰ 時間になったら声で通知する
こうした機能を持つシステムを、自分で開発できる可能性があります。
🔐 ④ セキュリティ監視
不審なログインやサイバー攻撃の兆候を検知した際に、音声で警告する仕組みも考えられます。
例えば、
「管理者アカウントへのログイン失敗が連続しています」
「不審な通信が検出されました」
といった内容を読み上げれば、セキュリティ監視にも活用できます。
🪟 Windowsでも使えるの?
ここは少し注意が必要です。
今回のOllama公式メールでは、macOSへの音声モデル対応が発表され、WindowsとLinuxについては今後対応予定と案内されています。
一方で、最新の音声ドキュメントにはWindowsおよびLinuxでの音声再生処理に関する説明も掲載されています。
ただし、現時点のPhonon公式モデルページでは、公開パッケージにApple Siliconが必要と記載されています。
そのため、WindowsにOllamaがインストールされているからといって、Phononをそのまま実行できるとは限りません。
Windowsで音声生成AIを動かしたい場合には、別のTTSエンジンを活用する方法もあります。
今後の対応拡大に期待したいところです!✨
⚡ どのくらい速いの?
公式発表によると、AppleのMLXを利用したPhononは、MacBook Pro(M5 Max)での測定において、比較対象の次点の実装よりも約35%高速に動作したとされています。
しかも、参照実装と同等の精度を維持しているとのことです。
ただし、この数値は公式が示した特定条件での測定結果です。
すべてのパソコンで35%高速になるわけではありません。
それでも、小規模なAIモデルによって音声を生成できる点は大きな魅力です。
💰 無料で使える?商用利用は?
OllamaはローカルAIを利用するためのソフトウェアであり、対応モデルを自分のPCで実行する際に、外部の音声生成APIへの従量課金を必ずしも必要としません。
ただし、モデルにはそれぞれライセンスがあります。
特にPhononについては注意が必要です。
- ✅ Phonon 31M English:Apache 2.0
- ⚠️ Phonon 40M系:CC BY-NC 4.0(非商用ライセンス)
そのため、生成した音声を収益化アプリや商用サービスで使用する場合には、使用モデルのライセンス条件を事前に確認する必要があります。
「ローカルで無料実行できる」ことと、「自由に商用利用できる」ことは別なので注意しましょう。
🔮 今後はどんな未来になる?
今回のアップデートは、単純な読み上げ機能の追加にとどまらない可能性があります。
これまでのAIは、文章を入力して文章を受け取る使い方が中心でした。
しかし、音声生成と音声認識を組み合わせれば、AIとのコミュニケーションが大きく変わります。
例えば、
🤖 AIが会話を理解する
🧠 AIが考える
🎙️ AIが音声で回答する
👂 人間が声で質問する
こうした一連の仕組みを、自宅のPCやローカルサーバーで動かすことも現実的になってきました。
さらに、ローカルAIなら外部サービスに依存する部分を減らす設計も可能です。
企業の内部システムや個人向けツールなど、プライバシーを重視した環境でも活用が期待できます。
📝 まとめ:Ollamaは「文章を作るAI」から「声を出すAI」へ!
今回発表されたSpeech modelsは、ローカルAIの活用範囲をさらに広げる機能です。
📌 今回のポイントをまとめると、
✅ Ollamaが音声生成モデルに対応
✅ Phononによるテキスト読み上げが可能
✅ AIが文章を生成し、そのまま音声で回答できる
✅ 音声をWAVファイルとして保存できる
✅ PythonやJavaScriptなどからAPI連携できる
✅ ゲームや監視ツール、AIアシスタントなどに応用可能
⚠️ Windows/Linuxや日本語対応には注意が必要
⚠️ 商用利用時はモデルごとのライセンス確認が必要
個人的には、今回の音声生成機能はかなり面白いアップデートだと感じています。
特に、これまでPowerShellやPythonで開発していたツールに音声機能を追加できれば、単なる監視ツールが「状況を声で知らせてくれるシステム」に進化します。
今後、日本語モデルの充実やWindowsへの対応が進めば、さらに活用の幅が広がりそうです。
パソコンの中に、自分専用の「しゃべるAI」を作る時代が近づいているのかもしれませんね! 🚀
🔗 参考リンク・公式情報
- 🏠 Ollama公式サイト
https://ollama.com/ - 🎙️ Speech models公式発表
https://ollama.com/blog/speech-models - 📚 音声生成機能の公式ドキュメント
https://docs.ollama.com/capabilities/speech - 🤖 Phononモデルページ
https://ollama.com/library/phonon
🏷️ タグ
#Ollama #生成AI #ローカルAI #Phonon #音声生成 #TTS #AIニュース #Python #PowerShell #AI開発 #オープンソース #IT技術
コメント